EMNLP 2024 | Unleashing the Power of Emojis in Texts via Self-supervised Graph Pre-Training
最后更新:
2026-11-03
创建日期:
2024-09-21
Table of Content
2024年9月20日,收到了论文《Unleashing the Power of Emojis in Texts via Self-supervised Graph Pre-Training》被 EMNLP 2024 主会录用的消息!
历史性的一刻!本网站建立的初衷其实就是为了记录自己的研究成果,但是在投paper的路上坎坎坷坷,遇到许多困难,后来本网站也逐渐转型成一个记录自己的学习生活的平台。今天终于回归本职工作!
作者: Zhou Zhang、Dongzeng Tan、Jiaan Wang、Yilong Chen、Jiarong Xu。本人和 Dongzeng Tan 为共同第一作者。
这篇论文做了什么?
我们把社交媒体中的帖子、词语和 emoji 放进同一张异构图,通过节点级对比学习与边级链接重建,让文本和 emoji 的表征相互补充。学到的表征可以与语言模型结合,用于帖子热度预测和情感分类。
为什么要研究 emoji?#
在社交媒体上,emoji 往往承载着文字之外的情绪和语气。同一个表情放在不同句子里,可能表达喜悦、无奈,甚至反讽。直接删掉它会丢失信息;只把它当成一个普通字符,或者替换成固定的文字描述,也很难保留这种依赖上下文的含义。
因此,我们关心的问题是:能否利用帖子本身的结构和上下文,在不依赖人工语义标注的预训练阶段,同时学习文本和 emoji 的表示?
方法:让帖子、词语和 emoji 在图中交流#
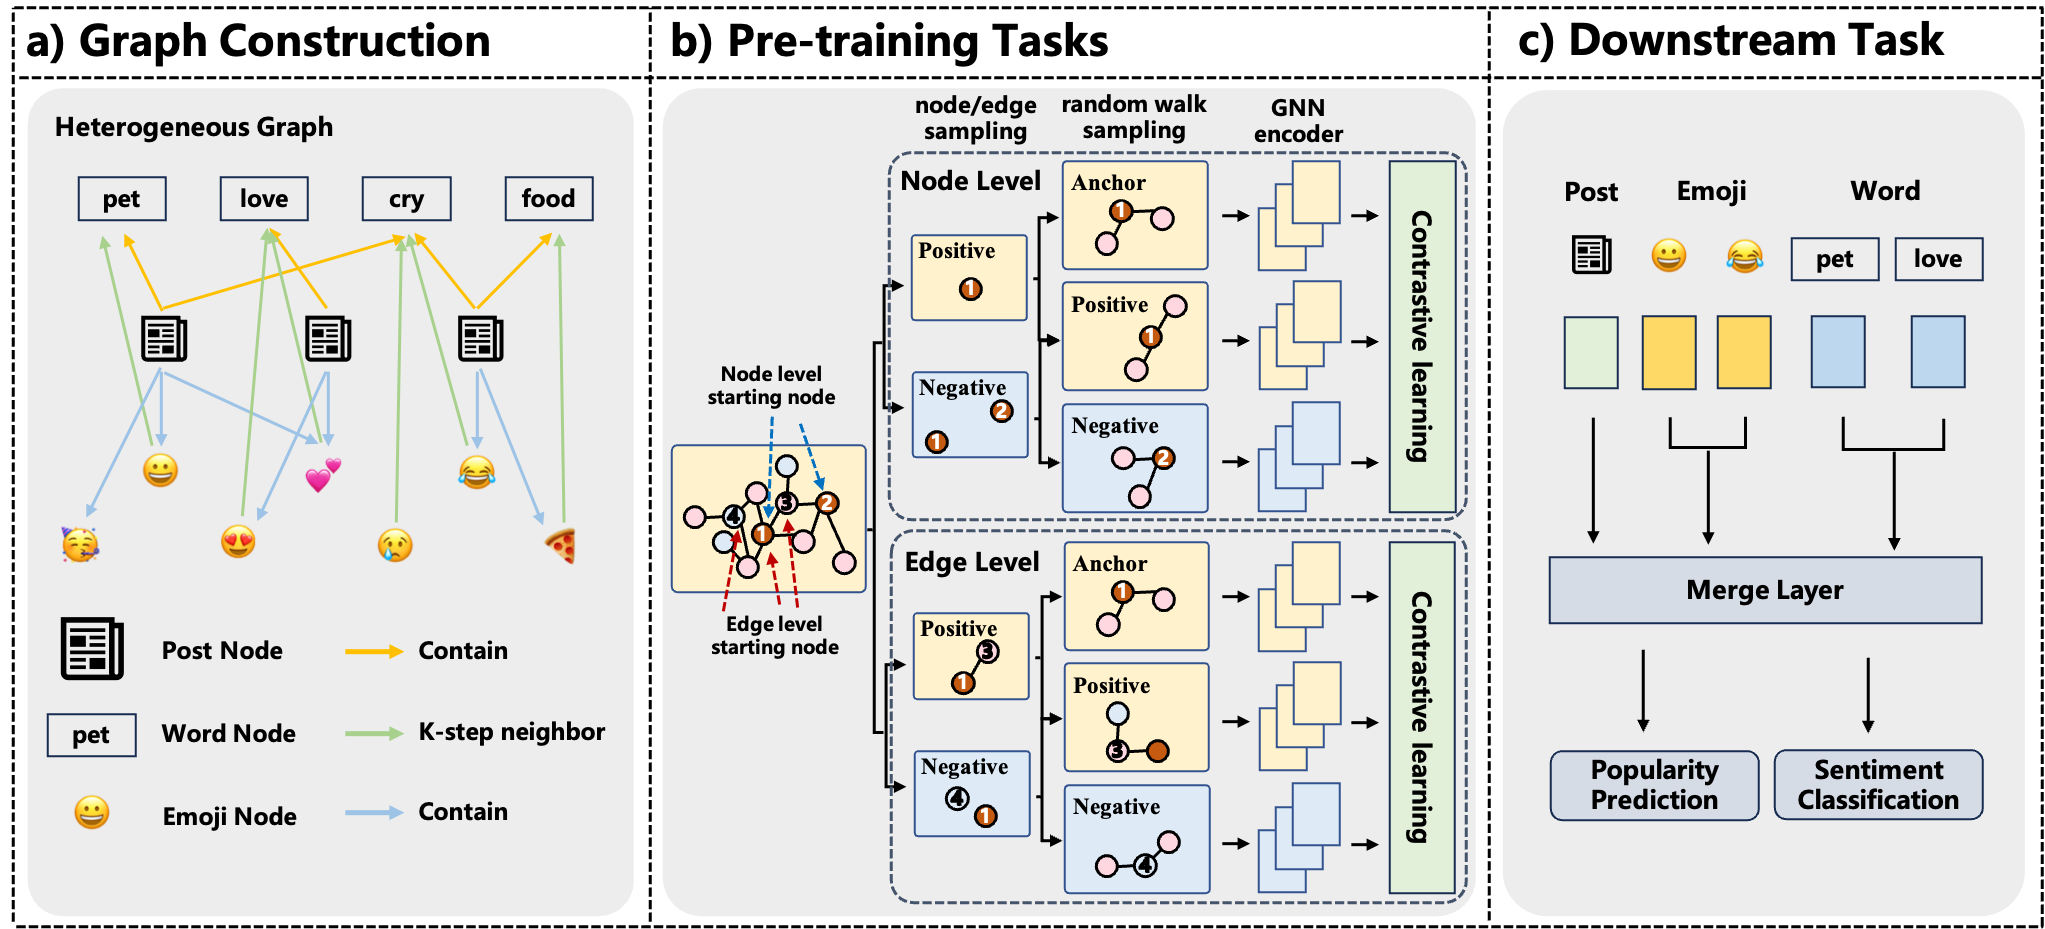
读图可以从左往右看:先把帖子中的文字和表情连接起来,再通过图上的自监督任务学习表征,最后把这些表示用于具体的预测任务。
原图标注说明
上图来自我本地保留的研究流程图,保持原样展示。图中边级任务的 “Contrastive learning” 是原始示意图标注;论文最终采用的是边级链接重建,即区分真实连接和采样的非连接。具体训练目标以论文及下文说明为准。
1. 构建异构图#
图中包含三类节点:帖子、词语、emoji。帖子和词语的初始表示来自预训练语言模型,emoji 的表示随机初始化,再通过图预训练学习。
| 连接关系 | 如何构建 | 希望保留的信息 |
|---|---|---|
| 帖子 ↔ emoji | 连接帖子与其中出现的 emoji | 表情与整篇内容的关联 |
| 帖子 ↔ 词语 | 连接帖子与 hashtag 中的关键词 | 帖子的主题,避免连接全部词语带来噪声 |
| 词语 ↔ emoji | 连接 emoji 与其局部窗口内的邻近词 | 表情的位置及附近语境 |
这样,使用相同表情或主题词的帖子可以建立间接联系,emoji 也可以从不同帖子的使用方式中积累语义信息。
2. 节点级子图对比学习#
从某个节点出发,通过随机游走采样不同子图。同一出发节点得到的子图作为正样本对;不同出发节点(但节点类型相同)得到的子图作为负样本对。利用 InfoNCE 对比损失,让同一节点的不同邻域视图更接近,帮助模型学习相对稳定的语义表示。这个任务分别用于帖子、词语和 emoji 节点。
3. 边级链接重建#
将图中真实存在的边作为正样本,随机采样不存在的连接作为负样本,让模型判断两个节点之间是否应当有边。三类连接都参与训练,分别对应帖子与表情的关联、关键词识别以及表情与邻近词的位置关系。
两个任务分别从节点邻域和跨类型连接出发,使用图神经网络编码器学习表示;实验采用两层 GIN。预训练后,将帖子中的 emoji 表征、文本与整个 emoji 表征集合的交互特征,与语言模型给出的文本表示拼接,再完成下游分类。
实验:这些表示能带来什么?#
小红书帖子热度预测#
我们收集了超过 400 万条小红书帖子。分别针对点赞、收藏和评论数量,按分位数划分低、中、高三档,把热度预测建模为三分类任务,而不是直接预测精确的互动次数。评价使用 加权 F1(Weighted F1),实验重复 10 次并报告平均结果。
下面摘录论文表 2 中 Llama2-7B 作为文本骨干模型时的结果。比较对象是同一骨干下各任务表现最好的基线:
| 预测任务 | 最佳基线 | 我们的方法 | 加权 F1 绝对提升 |
|---|---|---|---|
| 点赞档位 | Emoji Co-occurrence:0.4912 | 0.5120 | +0.0208 |
| 收藏档位 | Emoji2vec:0.4695 | 0.4776 | +0.0081 |
| 评论档位 | Emoji2vec:0.4631 | 0.4695 | +0.0064 |
论文也比较了 BERT、GPT2、RoBERTa 和 OPT-1.3B 等文本骨干。这里的增量是 F1 的绝对差值,不是相对百分比,也不代表对未来传播效果的因果判断。
Twitter 情感分类#
在包含 emoji 的 Twitter 帖子上,模型区分正面、中性和负面三类情感。论文表 4 中,我们的方法取得 0.5679 的加权 F1,高于 SEntiMoji 的 0.5512 和 Emoji2vec 的 0.5507。相较最强基线 SEntiMoji,绝对提升为 0.0167。
哪些部分起了作用?#
消融实验逐一移除节点级或边级预训练子任务,热度预测表现都会下降。这说明,在论文的实验设置下,帖子、词语、emoji 的邻域信息及它们之间的连接关系,都能为最终表示提供帮助。
局限与思考#
这项工作的前提是能正确识别和切分 emoji。它尚不能直接处理图片形式的表情包;对反讽、跨文化语义和多个表情混合表达的复杂情绪,也仍有判断错误。预训练中未出现的词语或 emoji 在下游处理中会被丢弃,存在词表覆盖的限制。另外,小红书数据出于隐私与伦理考虑不公开。
对我来说,这篇工作的一个收获是:理解社交媒体文本时,除了文字本身,还值得认真对待表情、局部位置和帖子之间共享的结构信息。
本文的方法与实验介绍依据 arXiv v2 全文整理;具体设置、完整结果和参考文献请以论文为准。